分辨率假说(一):Agent 自进化为什么总在“原地踏步”?
《分辨率假说》系列(1/3) · 论文 arXiv:2611.23068 · 项目主页与 30s 互动小游戏 · 幕后手记 连载导航:(一)原地踏步与方差账 · (二)高通滤波器与捷径审计 · (三)好 Skill 与失明的选择器
最近半年,我们团队花了大量精力去探索和复现“自进化智能体(Self-Evolving Agents)”。当然,现在这个领域有一个更时髦的名字了,“RSI”。这个方向的设定很吸引人:在基座模型权重 \(W\) 冻结的前提下,让智能体在与环境的交互中自我反思,不断迭代外挂的持久化状态 \(A\)(可以是 Prompt、Skill 文档、Memory 记忆库,甚至是 Agent 脚手架代码 Harness),从而实现测试时的能力进化。
然而,当我们真正把市面上主流的进化算法拉到一起横向评测时,却频繁遇到一个令人困惑的现象:不同论文里的结论经常互相打架。同一个算法,在论文 A 的基准上能稳定涨点,换到论文 B 里做 Baseline 就跑不出效果;到了像 Terminal-Bench 这样贴近真实软件工程的硬核基准上,几乎所有方法都会在几轮之内陷入“原地踏步”。
为了搞清楚这背后的原因,我们在 6 个模型、7 种主流进化方法和 13 个基准上跑了 1,030 次独立进化实验,每一次实验都要做上百次评估(累计超过 210 万条测试轨迹、1000 万次 LLM 调用,这可能是公开领域内规模最大的研究了!)。在这三篇连载博客中,我们想跳出具体方法的工程细节,用一套统一的数学与直觉视角,和大家聊聊我们在实验过程中逐步理清的一个核心问题:究竟是什么卡住了 Agent 自进化的脖子?
进化的统一视角
在动手跑实验之前,我们首先思考的一个问题是:市面上有改 Prompt 的(如 GEPA)、有提炼 Skill 的(如 SkillOpt、Trace2Skill)、有攒 Memory 的(如 ReasoningBank)、还有直接改 Agent 代码的(如 Meta-Harness、AHE),这些五花八门的方法,底层到底在做什么?
如果把传统的模型微调看作参数空间上的梯度下降 \(W_t = W_{t-1} - \eta \nabla L(W_{t-1})\),那么 Agent 进化面对的是一个离散的文本或代码空间。由于外部状态 \(A\) 必须通过影响智能体在环境中的多步采样轨迹(Trajectory)才能转化为最终得分,我们显然无法对 \(A\) 求导。
因此,所有现有的 Agent 进化方法,在数学上其实都退化成了同一个“提议-评估-选择(Propose-Evaluate-Select)”的零阶优化循环:
\[C_t = \text{Propose}(A_{t-1}, \mathcal{T}_{\text{train}}), \quad A_t = \text{Select}\big(A_{t-1}, C_t; \hat{Y}\big) \tag{1}\]也就是说,在每一轮 \(t\),提议器(Proposer)观察训练轨迹 \(\mathcal{T}_{\text{train}}\) 并写出候选产物 \(C_t\);随后评估器在验证集上测出观测得分 \(\hat{Y}\),选择器(Selector)则依据 \(\hat{Y}\) 决定保留哪些候选进入下一轮。
有了式 (1) 这个视角,社区目前主流的几种代表性方法就可以非常自然地对齐到同一张表里——它们的区别无非在于演化的对象 \(A\)、提议的粒度以及选择的规则不同:
| 进化方法 | 产物 \(A\) | 提议算子 \(\text{Propose}\) | 选择算子 \(\text{Select}\) |
|---|---|---|---|
| GEPA | Prompt | 每轮全量重写 | 3-task 训练集门控 + 验证集 Pareto 前沿采样 |
| SkillOpt-Lite | Skill 文档 | 每轮生成 1 条局部编辑 | 验证集得分高出当前产物 \(\ge 2\text{ pp}\) 则接受 |
| Trace2Skill | Skill 文档 | 每条轨迹提取 1 个 Patch 并层级合并 | 退化选择器(无条件接受全部 Patch) |
| ReasoningBank | Memory 记忆库 | 每任务提取 \(\le 3\) 条记忆追加 | 退化选择器(无条件接受全部记忆) |
| HarnessLens | 指令/Skill/工具描述 | 每轮生成 1 条编辑 | 训练集配对检验确认 + 验证集取最优 |
| Meta-Harness | Harness 代码 | 每轮重写完整程序(共 5 轮) | 5 个候选版本中取训练集最高分 |
| AHE | 完整代码工作区 | 每轮生成代码编辑(共 5 轮) | 5 个版本中取验证集最高分 |
Note:像 Trace2Skill 和 ReasoningBank 这类在常规基准上“只提取经验追加、不根据验证集分数做过滤”的方法,在式 (1) 的视角下并不是没有选择器,而是等价于一个接受概率恒为 \(1\) 的选择器(Degenerate Selector)——它不通过实机重跑实验区分好建议和坏建议,本质上和被高噪声误导的选择器面临着同样的风险。
浓雾爬山与“分辨率假说”
从式 (1) 我们可以看出,要让这个循环不断往上走,必须同时满足两个条件:第一,\(\text{Propose}\) 确实能写出真实质量更高的候选(即真实期望得分差 \(\Delta = Y(C_t) - Y(A_{t-1}) > 0\));第二,\(\text{Select}\) 能仅凭单次观测得分 \(\hat{Y}\) 把这些好候选挑出来。
过去大家发论文,几乎都在卷 \(\text{Propose}\)(设计更精巧的反思提示词、引入树搜索或群体档案),却默认了 \(\hat{Y}\) 是可靠的。但稍微想一想就会发现不对劲:由于模型权重是冻结的,一段文本 \(A\) 只能通过微调模型在推理时的行为倾向来发挥作用,而 LLM 每跑一次轨迹本身就有巨大的采样随机性。
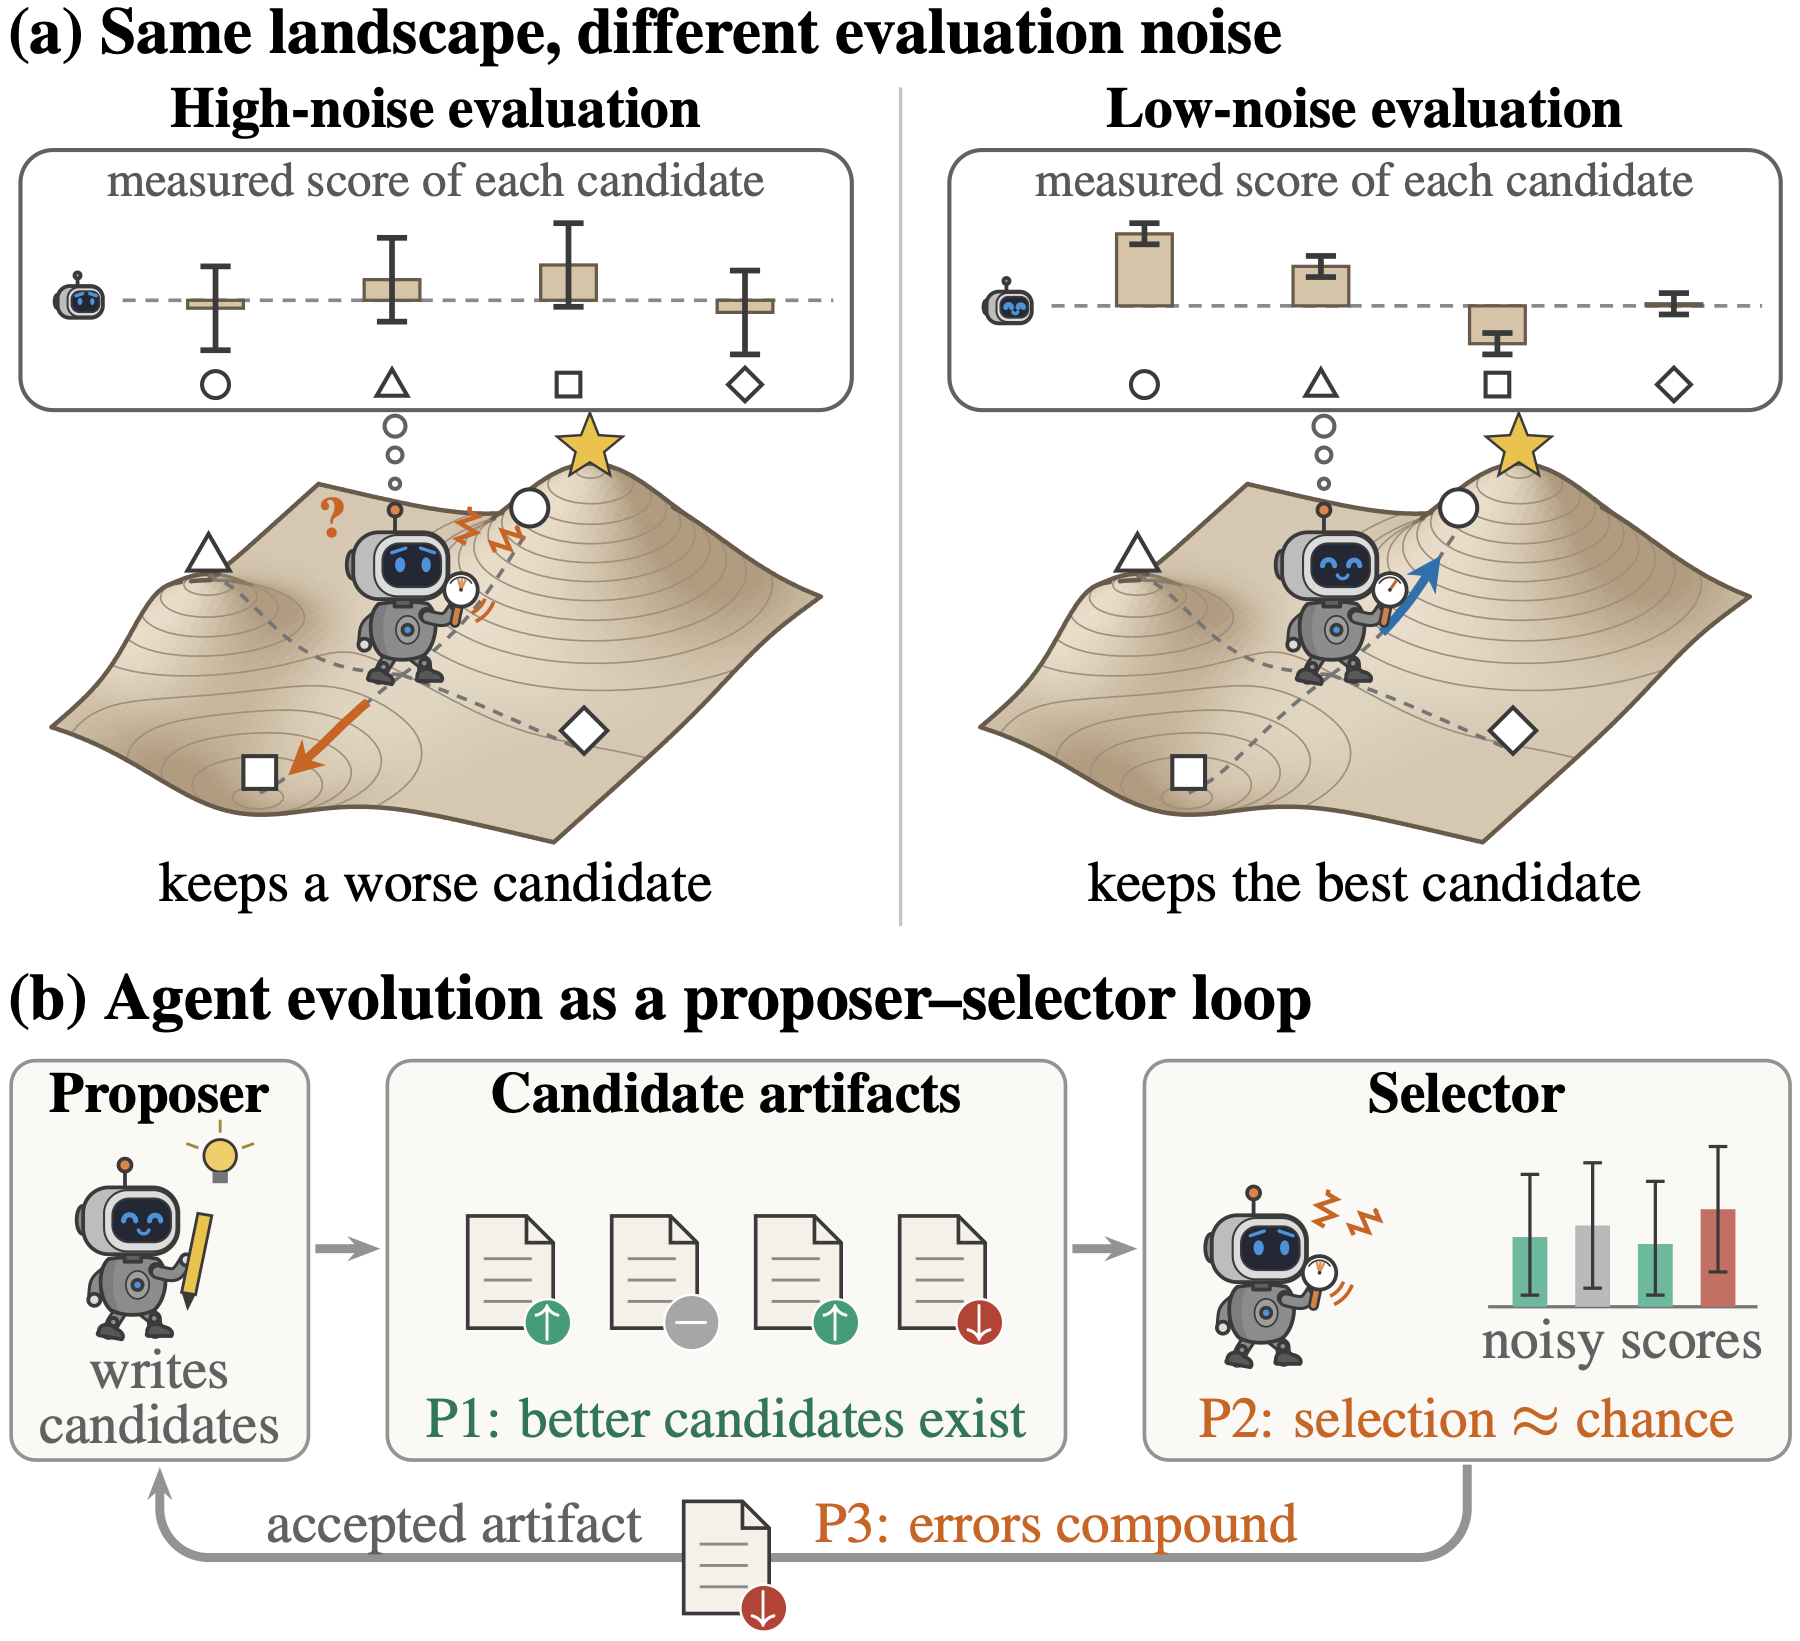
我们可以用一个很直观的物理图景来类比(图 1a):假设你在浓雾笼罩的山区爬山,提议器决定了你每迈出一步的真实高度差 \(\Delta\)(比如 \(+1\) 米或 \(-1\) 米),而评估系统则是你手里那块带有测量误差的海拔表(比如随机抖动 \(\pm 5\) 米)。当单步的真实改进 \(\Delta\) 小于海拔表的测量误差时,你看表选路就和抛硬币没两样了。
如果把一套评估流水线能够从噪声中可靠分辨出来的“最小真实改进量”定义为它的分辨率(Resolution),那么我们在实验中观察到的诸多怪象,都可以归结为一个简单的假说——分辨率假说(The Resolution Hypothesis):
Agent 自进化的瓶颈,不在于模型无法提议(Propose)出更好的产物,而在于评估系统的分辨率不足以识别(Identify)它们。
两个正交的方差分量
既然怀疑是分辨率不够,我们就需要把评估分数的噪声严格算出来。
考虑一个进化方法在某个基准上的表现。记产物 \(A\) 的真实能力(无限次重复评估的期望得分)为 \(Y(A) = \mathbb{E}[\hat{Y}\mid A]\)。单次评估观测到的分数可以写为 \(\hat{Y}(A) = Y(A) + \epsilon\),其中 \(\epsilon\) 是零均值的评估噪声。与此同时,由于进化过程本身也是随机的,同一个进化方法独立运行多次,每次生成的产物 \(A\) 其真实质量 \(Y(A)\) 也会不同。
由全方差公式(Law of Total Variance),单次运行所报告的分数 \(\hat{Y}\),其总方差严格分解为两个正交分量之和:
\[\text{Var}(\hat{Y}) = \underbrace{\mathbb{E}_A\left[\text{Var}(\hat{Y} \mid A)\right]}_{\sigma^2\text{(评估噪声方差)}} + \underbrace{\text{Var}_A\left(\mathbb{E}[\hat{Y} \mid A]\right)}_{\tau^2\text{(运行间方差)}} \tag{2}\]式 (2) 虽然简单,但它直接告诉了我们不同场景下的分辨率极限到底受谁制约:
- 当我们在进化循环内部(候选级)判断某一个固定候选产物 \(A\) 是否优于基线时,\(A\) 是给定的,分辨率只受限于 \(\sigma^2\);
- 当我们在论文表格里(方法级)横向对比两个不同的进化方法时,因为每次运行方法都会重新抽取一个产物 \(A\),分辨率受限于总方差 \(\tau^2 + \sigma^2\)!这就意味着,哪怕你在测试集上把同一个产物重复测上 100 遍(把测试评估噪声 \(\sigma^2/M\) 压到接近 \(0\)),只要你只跑了一次进化(\(R=1\)),你的方法得分依然带着 \(\tau^2\) 的固有方差。
为了给 \(\sigma\) 和 \(\tau\) 定量,我们在 ALFWorld、SpreadsheetBench、OfficeQA 和 Terminal-Bench v2.1 上,把上述 7 种方法和 6 个模型组成的 150 个配置全部跑了 \(R=8\sim 16\) 次独立进化,并对每个生成的产物在测试集上做了 \(M=8\sim 16\) 次独立评估,用方差分析(ANOVA)的无偏矩估计量分离出了 \(\hat{\sigma}\) 和 \(\hat{\tau}\)。
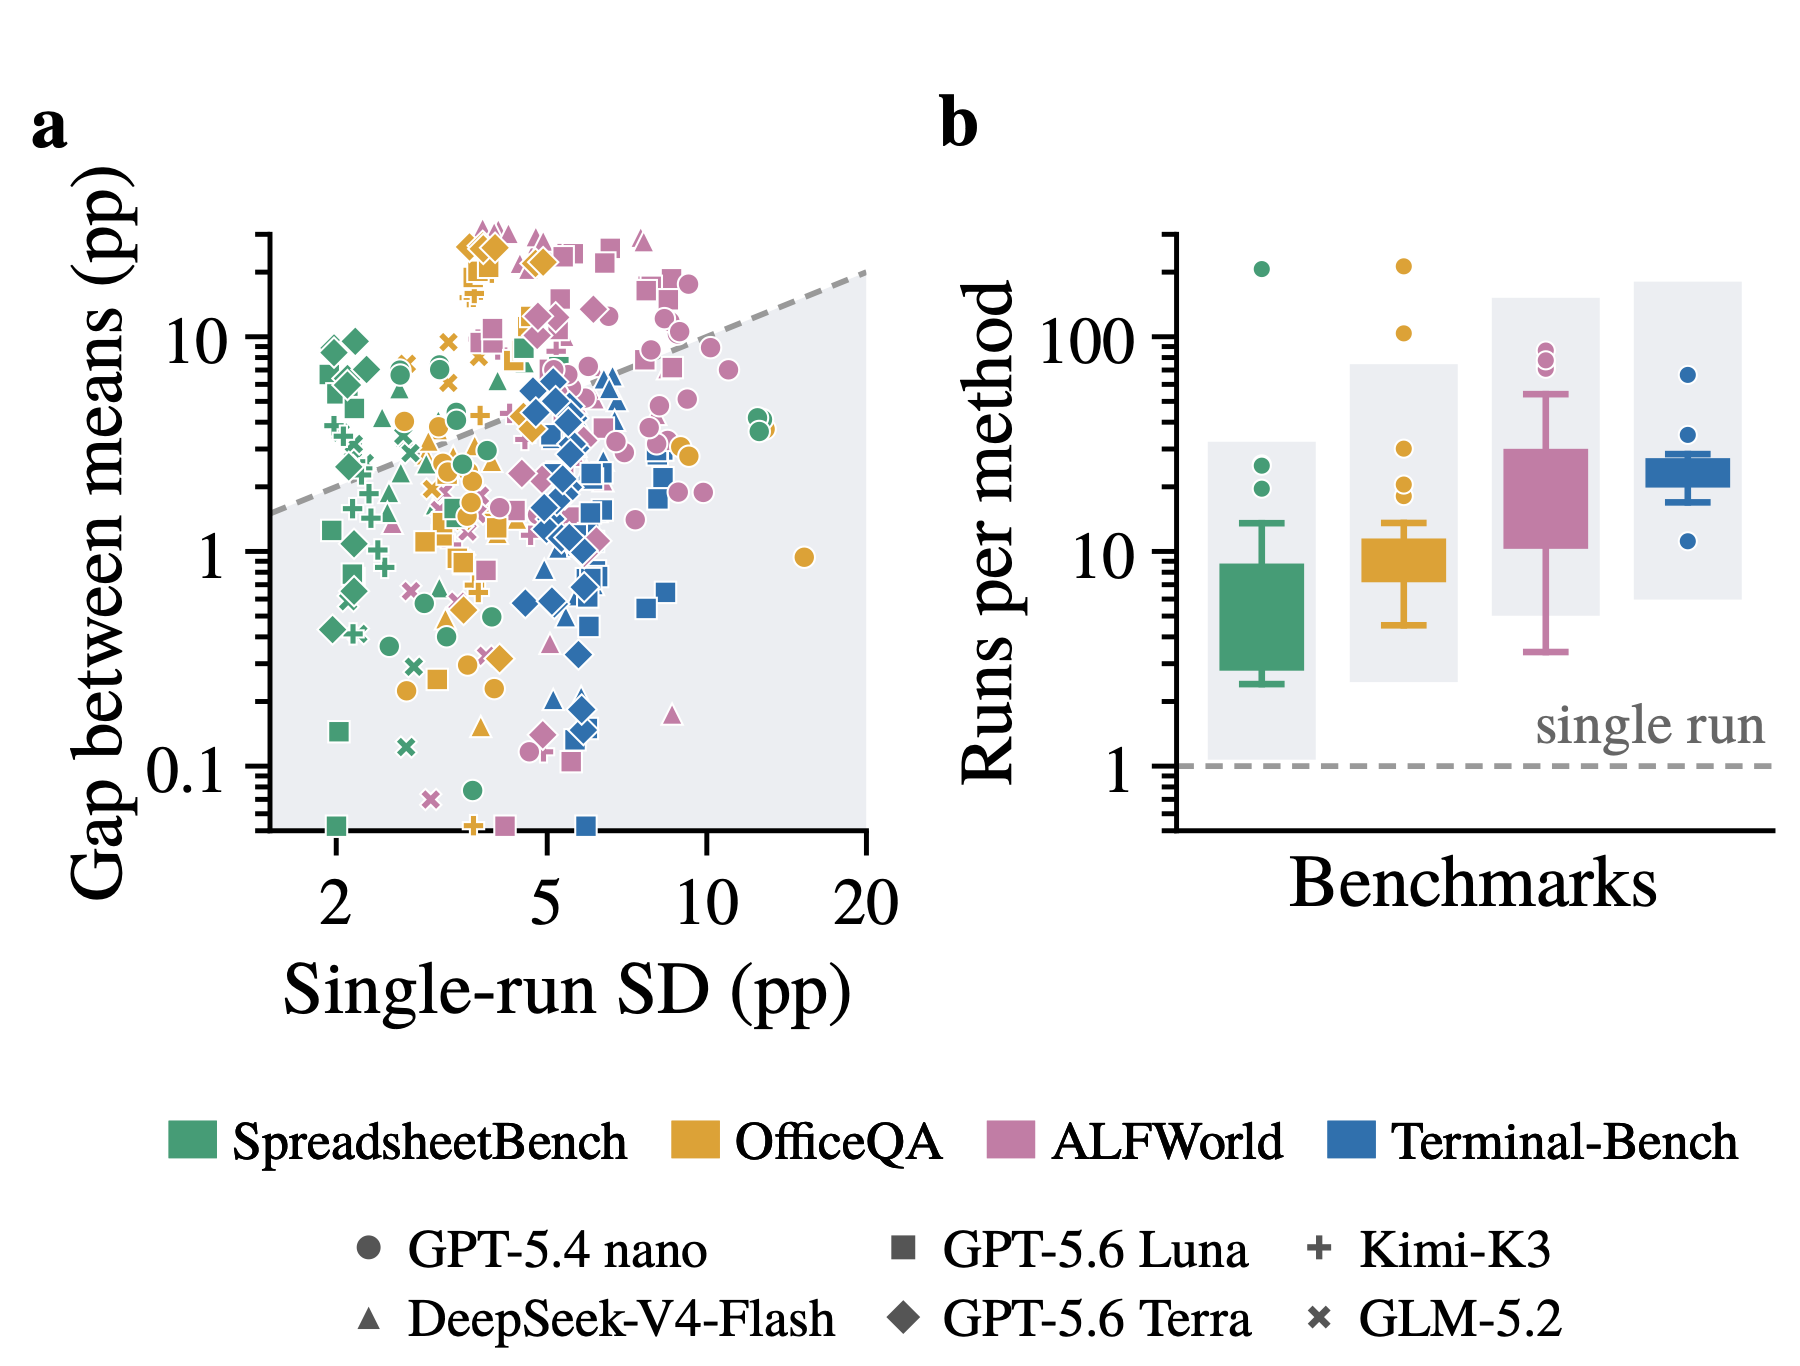
把算出来的数字和现有文献放在一起对比,有三个结论非常直观:
- 绝大多数方法之间的真实差距,小于单次运行的一个标准差。在四个基准上,评估噪声 \(\sigma\) 在 \(1.0\sim 4.5\text{ pp}\)(百分点)之间,而运行间标准差 \(\tau\) 则分布在 \(0\sim 12.3\text{ pp}\)。合起来看,一个方法“进化一次、评估一次”的单次标准差 \(s = \sqrt{\tau^2 + \sigma^2}\) 各基准中位数为 \(1.7\sim 4.1\text{ pp}\)。而在同模型、同基准的所有 341 对方法对比中,超过 60% 的方法真实均值差距,落在了单次对比的一个标准差 \(\sqrt{s_1^2 + s_2^2}\) 以内(图 2a 阴影区)。
- 现有论文宣称的 SOTA 领先幅度,恰好掉在这个噪声带里。我们统计了 9 篇代表性 Agent 进化论文主表里的 171 列有效对比,新方法领先同列最强竞争对手的中位数差距(Margin)恰好是 \(3.4\text{ pp}\)(四分位距 \(1.2\sim 6.6\text{ pp}\))。而且在这 171 列结果里,没有一个报告方差或误差棒,有 152 列甚至没有说明跑了几次进化(更有趣的是,有 4 篇论文在重跑别人家的最强竞争方法时,跑出来的分数甚至低于什么都不加的零样本 Baseline)。
-
单次实验的排名近乎“开盲盒”。由式 (2) 不难推导出,要在显著性水平 \(\alpha=0.05\)、统计功效 \(1-\beta=80\%\) 下识别出 \(\Delta\) 的真实差距,每个方法所需的独立进化运行次数为:
\[N \ge 2 \cdot \left(\frac{z_{1-\alpha/2} + z_{1-\beta}}{\Delta}\right)^2 \cdot \left(\tau^2 + \frac{\sigma^2}{M}\right) \tag{3}\]若取文献中位数差距 \(\Delta = 3.4\text{ pp}\)(且单次评估 \(M=1\)),在 SpreadsheetBench、OfficeQA、ALFWorld 和 Terminal-Bench 上分别需要独立跑 5 次、10 次、19 次和 23 次进化(如果是下四分位的 \(1.2\text{ pp}\) 差距,Terminal-Bench 上需要跑 181 次)才能识别这种提升。显然,这远远高于大部分工作的汇报标准。如果我们按当前惯例每个方法只跑 1 次,在 Terminal-Bench 上挑出 4 个文本进化方法中真正第一名的概率只有 33%(完全随机盲猜是 25%),排对全部 4 个方法顺序的概率更是只有 8%。
疑问
算完方法级的这笔方差账,我们明白了为什么那么多方法在对比时总是在两三个点的区间里来回洗牌。
但这立刻引出了一个看似矛盾的现象:既然单次运行的分辨率连 \(3\sim 4\text{ pp}\) 的改进都很难识别,为什么在某些基准(比如 SpreadsheetBench、LiveMathematicianBench 或 AIME)上,前人论文和我们自己的实验都能跑出 \(+20\text{ pp}\) 甚至 \(+40\text{ pp}\) 的惊人涨幅?
在下一篇里,我们就顺着“分辨率假说”往下推演,去拆解那些暴涨三四十分的进化产物里,模型到底写出了什么。
如果大家对我们的工作感到赞赏或有所启发,欢迎阅读论文全文 arXiv:2611.23068、前往项目主页查看交互式数据与 30 秒互动小游戏,或在 HuggingFace Papers 点赞评论支持!
Enjoy Reading This Article?
Here are some more articles you might like to read next: