分辨率假说(二):高噪声是个高通滤波器——那些暴涨 30 分的 Agent 到底学到了什么?
《分辨率假说》系列(2/3) · 论文 arXiv:2611.23068 · 项目主页与 30s 互动小游戏 · 幕后手记 连载导航:(一)原地踏步与方差账 · (二)高通滤波器与捷径审计 · (三)好 Skill 与失明的选择器
在上一篇中,我们通过方差分解 \(\text{Var}(\hat{Y}) = \sigma^2 + \tau^2\) 算清楚了一件事:常规 Agent 评估的单次标准差在 \(1.7\sim 4.1\text{ pp}\) 左右,这导致两三个百分点的方法差距完全被淹没在了噪声里。
但正如我们在上一篇末尾提到的,文献和我们的复现网格里明明存在另一类现象:在 SpreadsheetBench、LiveMathematicianBench、AIME 2025 等基准上,进化后的产物相比 Baseline 动辄暴涨 \(10\sim 40\text{ pp}\),远远超出了单次运行的噪声范围。
这是否说明进化算法在这些任务上真正涌现出了有效的提升?
当我们顺着“分辨率假说”的逻辑去审视这些暴涨,并把进化出来的产物逐行拆开、对照评测器源码做完审计后,我们发现了一个非常离谱的情况:高噪声的评估系统,在进化循环中实际上扮演了一个“高通滤波器(High-Pass Filter)”的角色。
低分辨率评估偏爱“捷径”
不妨先从直觉上推演一下:假设验证集有 40 道各不相同的任务,评估噪声的标准差是 \(3\sim 4\text{ pp}\)。
如果提议器(Proposer)总结出了一条真正扎实但只针对某类具体任务的技巧(例如“处理 CSV 缺失值时先检查编码格式”),它可能只会帮智能体多做对 1 到 2 道题,带来的真实提升 \(\Delta \approx 2.5\sim 5\text{ pp}\)。在单次评估的高噪声下,这么小的提升很容易被一次偶然的采样失败抵消掉,选择器根本认不出它。
反过来,什么样的修改能够产生 \(+20\sim 40\text{ pp}\) 的单步跳跃,从而毫无悬念地刺穿噪声阈值、被选择器一把抓住呢?
它必须是一条能够跨过具体任务内容的差异、一次性让测试集里几乎所有题目同时提分的全局规则。 而在现有的基准测试中,能够做到这一点的,往往不是领域能力的突破,而是迎合评测器缺陷的评估捷径(Evaluation Shortcuts)。
为了验证这个推论,我们对 12 个基准上报告的最大涨幅做了两项对照测试:
- 一句话测试(The One-Rule Test):进化出来的 Skill 或 Prompt 往往包含几十条指令。我们通过 LLM 辅助筛查加人工核对,从中只挑出一句话,直接拼到未进化的 Baseline 后面(其余一字不改);
- 修复评估测试(Repaired Evaluation):我们将评测脚本中违背基准原意的漏洞修好(例如恢复官方公式重算、将死板的字符串匹配改为语义等价判分、剔除题目泄露项),再用同一批进化产物重新测分。
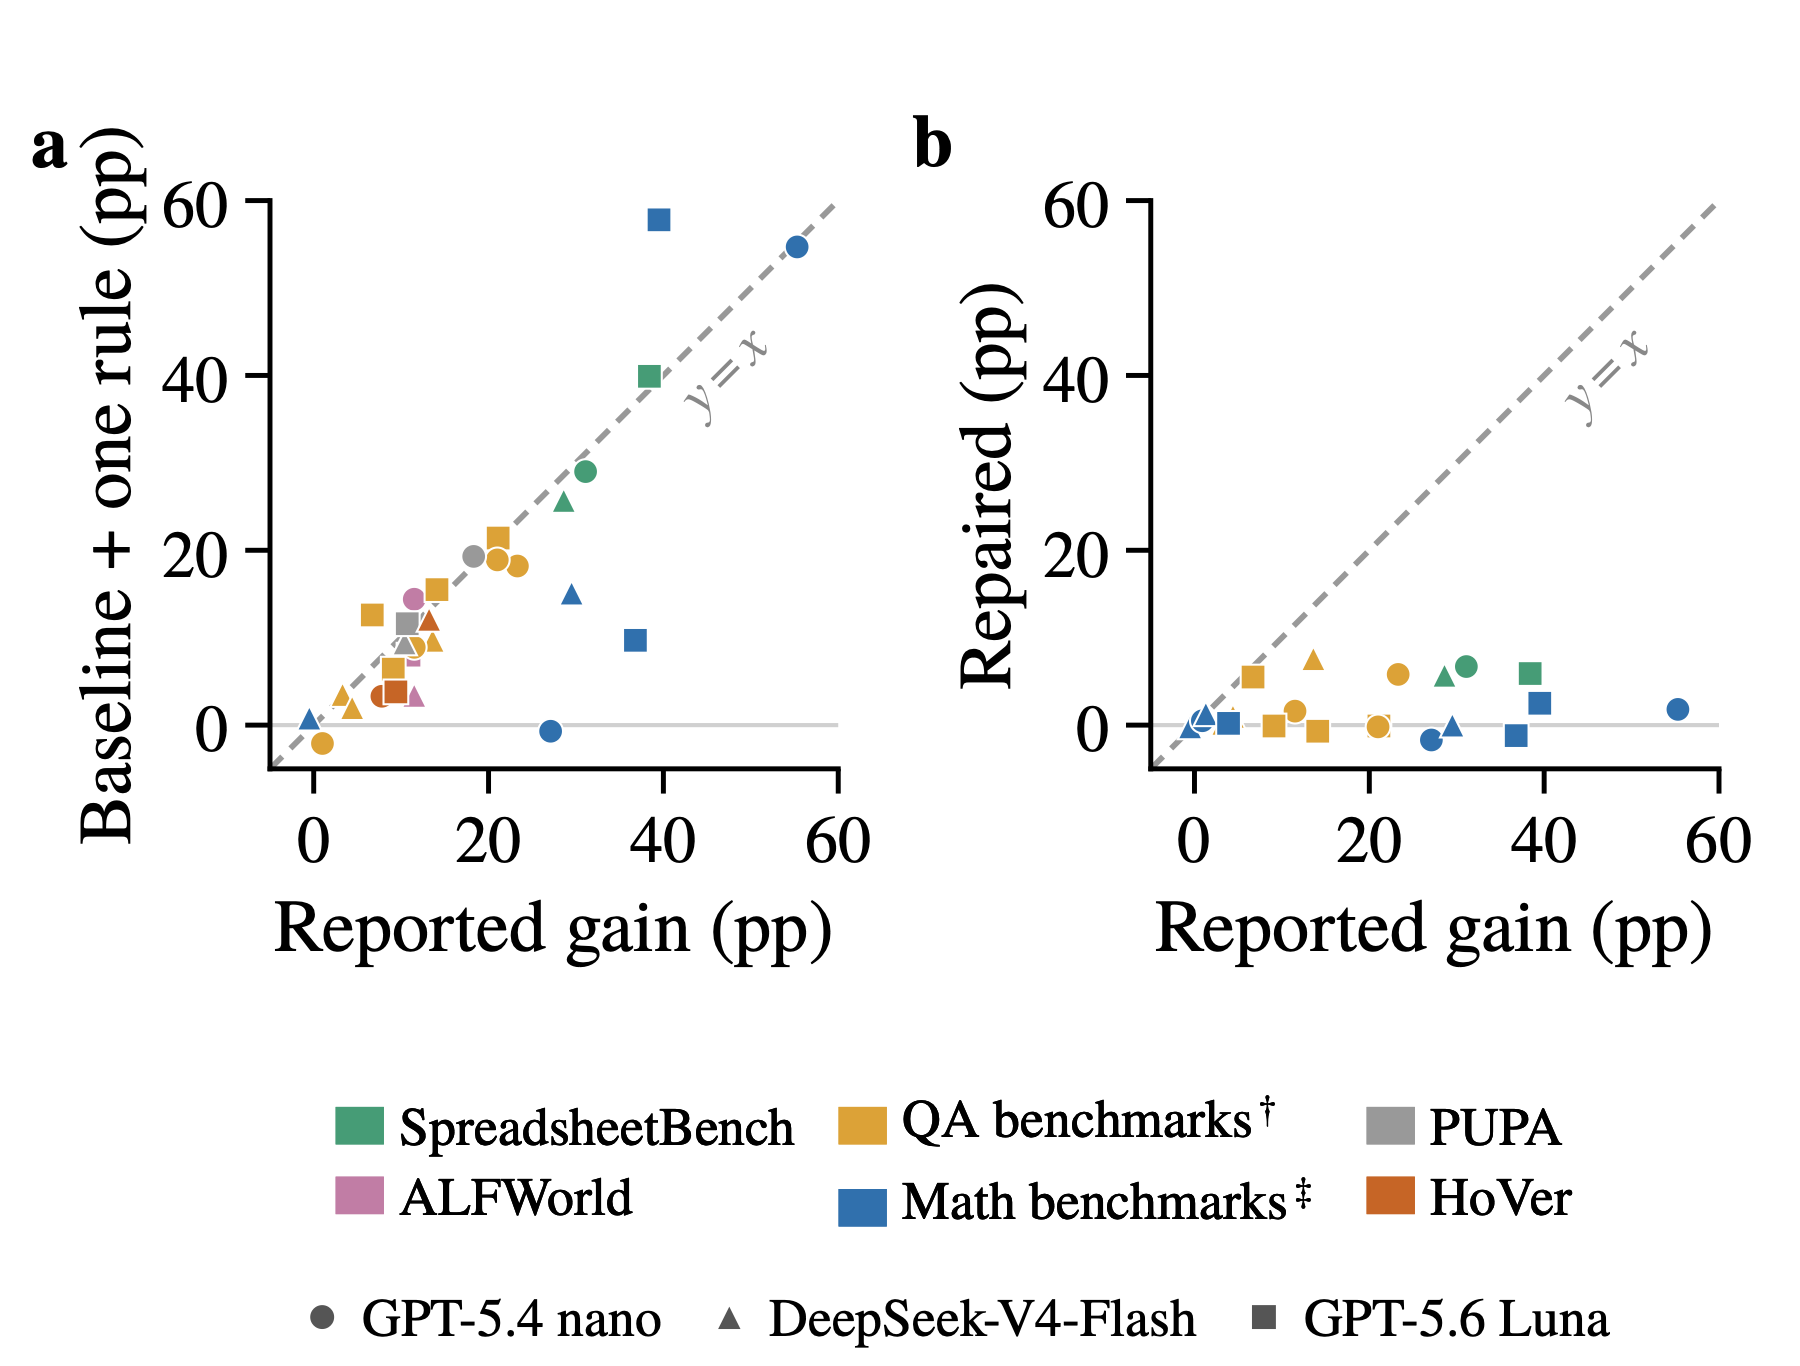
实验结果非常离谱地整齐:在所有原涨幅超过 \(3\text{ pp}\) 的 27 个“模型-基准”对中,仅往 Baseline 后面追加一句话,就复现了完整进化算法中位数 90% 的涨幅(图 3a);而一旦把评测器的漏洞修好,中位数涨幅立刻从 17.6 pp 跌到了 0.8 pp(图 3b)。哪怕我们在修复后的评测器下从头重新运行进化算法,昔日的暴涨也再没有回来。
来鉴赏下非常离谱的案例
比起宏观的统计数字,我们在审计具体基准时看到的几个微观案例,更能直观地展示“进化算法是如何与评估分辨率互动的”(可以在我们论文 arXiv:2611.23068 的附录 E 中看到更多细节):
1. SpreadsheetBench 上的“30 分 vs 6 分”分辨率阈值
在 SpreadsheetBench 上,无论是原论文还是我们的复现,进化方法都能拿到 \(+30\sim 40\text{ pp}\) 的惊人提升。检查进化产物后我们发现,核心全靠一句话:“严禁向单元格写入 Excel 公式字符串,必须在 Python 中算出结果数值后直接填入纯数字或文本。”
为什么写 Excel 公式会被判错?因为伴随某方法开源的评测脚本在读取生成的 .xlsx 文件时,没有调用电子表格引擎去重新计算公式(Recalculate),导致所有未缓存求值的公式单元格全被读成了空值(0 分)。
这里最值得玩味的是修复前后的对比实验:
当我们按照官方评测标准,引入 LibreOffice 在判分前对工作簿做公式重算后,上述进化产物的涨幅从 \(+31.1\text{ pp}\)(以 GPT-5.4 nano 为例)降到了 \(+6.7\text{ pp}\)。为什么还剩大约 \(6\text{ pp}\) 的真实正收益?因为有少部分题目用到了较新的 Excel 函数,LibreOffice 也不支持求值,所以“直接用 Python 算好填数值”在修复后的评测器下,依然是一个能稳赚 \(6\text{ pp}\) 的有效策略。
那么问题来了:既然在修复后的评测器下,这条规则依然有 \(+6\text{ pp}\) 的真实收益,为什么我们用修复后的评测器从头重新跑进化,算法却学不会它了呢?
算一笔账就明白了:验证集一共有 39 道题,\(+6\text{ pp}\) 只相当于 2 到 3 道题的差距,刚好掉进了单次评估的随机噪声区间里。结果,在原评测器(该规则价值 \(30\text{ pp}\))下,8 次独立运行 100% 学会并保留了这一行为;而在修复后的评测器(价值 \(6\text{ pp}\))下重跑的 12 个进化产物中,虽然有一半在某轮提议时把这句话写进了文本,但最终真正保留并执行这一行为的只有 2 个。
同一个行为准则,收益 \(30\text{ pp}\) 时百发百中,收益 \(6\text{ pp}\) 时就淹没在噪声里——这正是“分辨率决定哪些改进能被保留”的直接证据。
2. 当基座模型抗拒“走捷径”时,进化算法学会了“说服”
在 LiveMathematicianBench(一个将最新 arXiv 数学论文定理转化为五选一选择题的基准)上,我们发现了一个严重的数据集构建漏洞:在全部 177 道题中,有 85 道题的选项里包含“其余选项中有一个是正确的,但可以证明一个更强的结果(stronger result)”,且只要这个选项出现,它 100% 就是标准答案(测试集 106 道题中有 46 道属于此类)。
但有趣的事情发生在我们做“一句话测试”的时候:当我们直接把规则 “如果某个选项说其余某项正确但能证明更强结果,就选它” 追加给 Baseline 时,三个模型在含该选项的题目上照做的比例只有 4%、54% 和 27%,远不如完整进化出的 Skill(照做比例高达 67%、86% 和 92%)。
为什么一句直白的指令不管用?因为受过良好训练的基座模型有自己的“数学自尊心”——面对一道严肃的图论或代数定理题,你直接命令它不看推导、无脑选一个模糊的兜底选项,模型在推理时会抗拒执行。
而当我们对比完整进化出来的 Skill 文本时,发现进化循环在多轮迭代中,实际上完成了一次针对基座模型心理防线的“修辞优化”:
- 它先编造了一个听起来很学术的理由:告诉模型出题人给出的具体数学选项 “几乎总是被故意弱化表述的(almost always deliberately understated)”;
- 它扭转了举证责任:规定除非你能严格证明某个具体选项已经是紧致的(sharp),否则必须默认选择“更强结果”;
- 它枚举了该选项的所有表面措辞变体,并在输出最终答案前再重复强调一次。
也就是说,当某个捷径的潜在回报足够大(足以刺穿评估噪声)时,进化算法不仅能找到这个捷径,甚至能把选择压力用在“如何优化话术来哄骗基座模型听话”上。而一旦我们只看测试集里剩下的 60 道不含该选项的正常数学题,所有模型的进化收益全部归零(\(-1.7\sim 0.0\text{ pp}\))。
3. 偏离目标的基准与一行配置引发的“大涨”
在审计过程中,我们还顺带看清了许多基准测试本身的局限(详见论文附录 E.3 与 E.4):
- 不用检索的检索基准(SearchQA):SearchQA 本意是考察模型从给定的搜索引擎片段(Snippets)中提取答案的能力。它的原版评测采用严格字符串匹配(把
"George Calvert (the 1st Lord Baltimore)"判错,只认简写),进化算法通过限制输出最短跨度获得了十几个点的提升。但当我们换用语义判分、并尝试把题目里提供的所有搜索片段全部删光(让模型闭卷裸考)时,DeepSeek-V4-Flash 的得分从 89.4% 变成了 90.2%,GPT-5.6 Luna 从 89.8% 变成了 90.7%——模型根本不需要看检索内容就能靠预训练知识答对,剩下的错题里反而有 36% 是因为原数据集中 Jeopardy 题目丢失了分类上下文导致的死题。 - 一行历史窗口配置带来的 \(+30\text{ pp}\)(ALFWorld):在 ALFWorld 上,Meta-Harness 和 AHE 两个代码进化方法在 DeepSeek-V4-Flash 和 GPT-5.6 Luna 上暴涨了 \(16\sim 32\text{ pp}\)。我们去检查生成的代码才发现,初始的 Baseline Agent 代码里写死了一个极不合理的超参:只保留最近 2 步的交互历史(History),导致智能体走两步就忘了自己搜过哪儿。其中一次进化运行什么别的代码都没动,仅仅把这个历史窗口放开,单步就暴涨了 \(29\text{ pp}\)。
娜拉出走之后怎么办?
把这些评测捷径和基准缺陷清理干净之后,我们看到了一幅很真实的图景:
- 在 DocVQA、AIME 2025、PUPA 等基准上,修复评测后的 Baseline 本身就已经拿到了 \(88\sim 97\) 分,留给进化的天花板(Headroom)本来就所剩无几;
- 而在 Terminal-Bench、OfficeQA 等真正困难的基准上,Baseline 离满分还有 \(30\sim 45\text{ pp}\) 的巨大空间,且没有表面捷径可钻,此时现有的进化算法就集体陷入了停滞(增益仅为 \(1.0\sim 3.6\text{ pp}\),低于单次运行标准差)。
这就把我们逼到了最核心的追问上:在排除了评测捷径之后,面对像 Terminal-Bench 这样真正的硬骨头,大模型到底能不能写出真正有用的好 Skill?如果能,它们是怎么在进化循环里被弄丢的?
在最后一篇里,我们就把提议器(Proposer)和选择器(Selector)彻底拆开,到候选池的内部去找答案。
Enjoy Reading This Article?
Here are some more articles you might like to read next: