分辨率假说(三):LLM 写出了好 Skill,我们却挑不出来
《分辨率假说》系列(3/3) · 论文 arXiv:2611.23068 · 项目主页与 30s 互动小游戏 · 幕后手记 连载导航:(一)原地踏步与方差账 · (二)高通滤波器与捷径审计 · (三)好 Skill 与失明的选择器
在前两篇讨论中,我们确立了两个事实:第一,常规单次评估的方差(\(1.7\sim 4.1\text{ pp}\))盖过了绝大多数方法的均值差;第二,那些能够刺穿噪声实现 \(+30\text{ pp}\) 暴涨的案例,大多源于一次性抬高全局分数的评测捷径。
当我们将评测捷径修复,或者来到像 Terminal-Bench v2.1 这样每个任务都在独立 Docker 容器中运行、由严格的单元测试判分的硬核基准上时,进化算法的收益便跌回了噪声带内。
这时候,一个关乎整个领域走向的问题摆在了我们面前:在真正的硬核任务上进化停滞,到底是因为 LLM 的能力不够、写不出能提升工程表现的候选产物(Proposal 瓶颈),还是因为好产物其实已经被写出来了,只是评估选择器没能把它们认出来(Selection 瓶颈)?
在标准的端到端进化循环 \(A_t = \text{Select}(A_{t-1}, \text{Propose}(A_{t-1}))\) 中,这两步是死死绑在一起的:如果你看到最终分数没涨,你根本无法区分是 \(\text{Propose}\) 没产出,还是 \(\text{Select}\) 漏掉了。因此,在本篇中,我们做的第一件事就是把提议和选择解耦看看怎么回事。
静态候选池:池子里其实躺着 \(+11.4\text{ pp}\) 的“真金”
为了在不引入选择器偏见的前提下观察提议器的真实水平,我们从 Terminal-Bench v2.1 和 DeepSWE 的执行轨迹中,用一个极简的提议器离线生成了 \(n=100\) 个候选 Skill,构成一个固定的候选池。随后,我们在 10 个不相交的 Terminal-Bench 测试任务上对每个候选进行了 \(16\) 次重复采样(Rollouts),并在 11 个任务的 Selection Pool 上做了 \(8\sim 15\) 次重复采样。
由于有限次二元采样仍有波动,我们采用经验贝叶斯层级模型(Empirical-Bayes Hierarchical Model)跨候选池化信息,对每个候选 \(i\) 在任务上的真实潜在成功率 \(\theta_i \sim \text{Beta}(a,b)\) 进行后验估计,并观察从池中随机抽取 \(K\) 个候选时最优候选的期望质量(Quality@K)。为了消除“候选越多、碰巧抽中幸运极值的统计期望自然越高”的假象,我们用等质量零假设(Equal-Quality Null,即假设所有候选真实成功率完全相同)进行了校准。
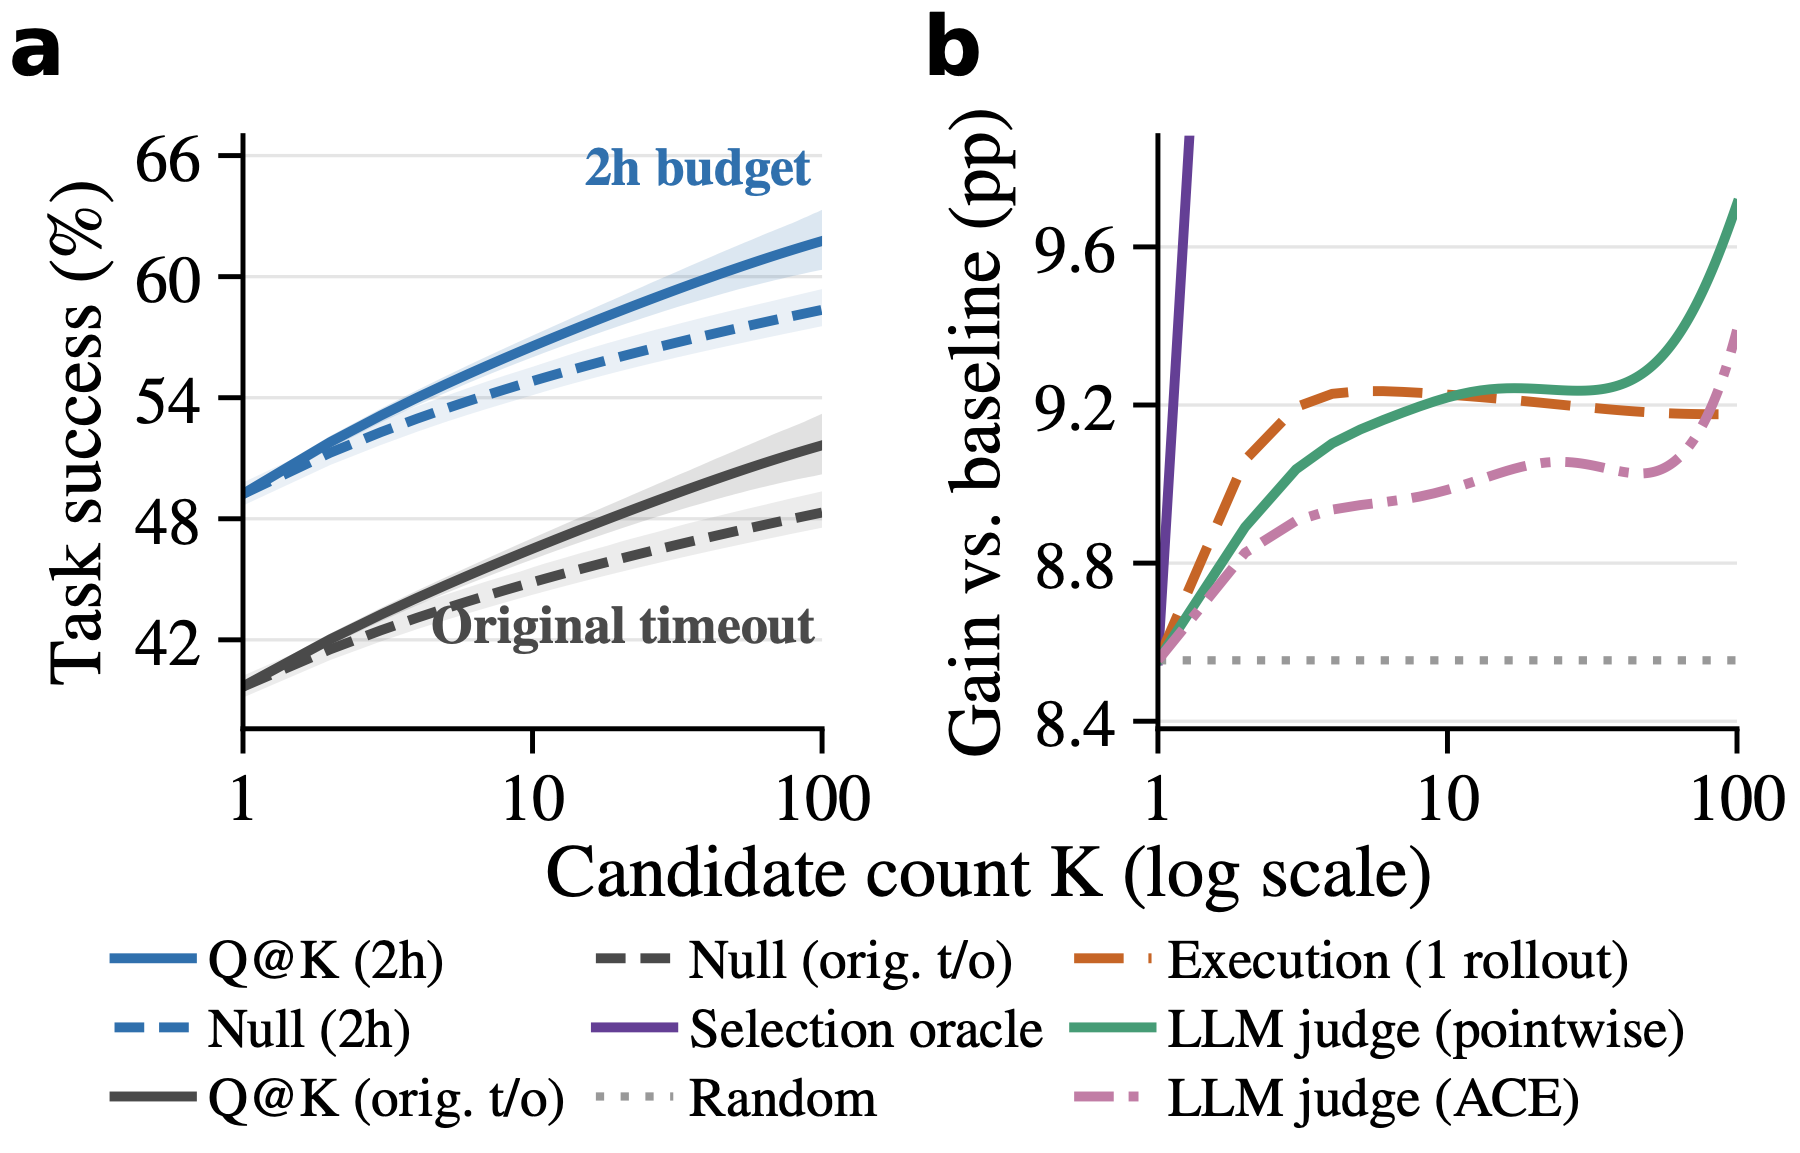
实验结果非常明确地支持了我们的第一个候选级推论(P1:候选池中存在真实有效的改进产物):
- 单任务上升空间存在:如图 4a 所示,随着候选数 \(K\) 从 \(1\) 增加到 \(100\),观测到的
Quality@K曲线显著离开了等质量零假设的 95% 置信带(2 小时预算下从 49.2% 升至 61.8%,超出零假设 \(+3.4\text{ pp}\)),上升幅度与第二篇中修复评测后留存的真实改进量级相当。 - 不仅有局部特化解,更有可跨任务泛化的通用 Skill:由于
Quality@K允许每个任务挑选各自最好的 Skill(例如池中的seed-058在mteb-retrieve任务上每次采样都能拿满分,但共享到其他任务上几乎没有帮助),我们还进一步检验了全局共享下的表现。当我们将这 100 个候选按全部 11 个测试任务的平均收益排序时,排名前二的seed-027和seed-099(见我们论文的附录 I.1),在严格测试下跨任务平均击败 Baseline 达 \(+11.4\text{ pp}\)!
打开 seed-027 的原文,可以看到 LLM 从失败轨迹中提炼出了非常具体的软件工程契约,例如:
- 克制符号重命名冲动:模型总结出,当任务提示词明确给出了类名、函数签名或特定空值返回格式(例如要求导出
Mean(xs []int) (float64, error)且空切片返回(0, nil))时,Agent 极易自作主张将其改写为更符合个人编程习惯的名字(如computeMean或Servicer类)或返回(-1, err),导致隐藏的评测脚本import失败。因此必须在动手写代码前提取所有字面量符号,用一字不差的薄封装(Shim)对齐公共接口。 - 规范第三方分词与检索编码调用:在处理依赖特定 Tokenizer 或 Embedding 模型的任务时,严禁手搓分隔符拼接文本(因为 BPE 分词器中
"a b"与"a\nb"的子词合并行为不同,会改变精确计数),且在调用指令感知的编码器时,必须显式分离 Query 与 Passage 的prompt_type参数,绝不混用默认配置。
这说明,哪怕只用最基础的提议器,LLM 也完全有能力从轨迹中提炼出价值 \(+10\text{ pp}\) 以上的硬核工程经验。既然金子已经在池子里了,为什么进化算法拿不到?
为什么 LLM 裁判也失灵了
有了这个已知真实后验质量的 100-Skill 候选池,我们就可以把市面上各种选择器(Selectors)单独拎出来,在真实的进化验证预算下(每个候选看 1 到 2 次执行 Rollouts),考考它们的鉴别力(检验推论 P2)。
为了防止数据泄露,我们采用独立参考集协议(Independent-Reference Protocol):选择器只看每个候选的前 1~2 次 Rollouts,而评估选择器挑出的产物好坏时,则使用剩余未见过的所有 Rollouts 拟合出的后验真实质量。
下表的结果直接揭示了病灶所在(也可以见图 4b 右侧子图):
| 选择机制 (Selection Mechanism) | 成对比较准确率 (Pairwise Acc. %) | 错误接受率 (False Accept. %) |
|---|---|---|
| Random(纯随机盲选) | \(50.0 \pm 0.0\) | \(30.5 \pm 14.0\) |
| Execution (1 rollout,单次执行得分) | \(49.7 \pm 1.9\) | \(62.1 \pm 42.9\) |
| SkillOpt-Lite 原生选择算子 (2 rollouts) | \(48.6 \pm 2.6\) | \(59.4 \pm 46.2\) |
| GEPA 原生选择算子 (2 rollouts) | \(48.6 \pm 2.6\) | \(31.6 \pm 14.5\) |
| LLM Judge (Pointwise 单点轨迹打分) | \(45.4 \pm 4.5\) | \(39.9 \pm 17.5\) |
| LLM Judge (Pairwise 成对轨迹比较) | \(49.0 \pm 2.2\) | \(57.6 \pm 23.3\) |
| LLM Judge (ACE 无真值反思模板) | \(46.9 \pm 3.5\) | \(39.0 \pm 15.6\) |
从表中可以看出两件非常关键的事:
- 基于执行分数的选择器在统计上等同于随机盲选:在两两比较中,单次执行得分挑出更优 Skill 的概率是 49.7%,哪怕像 SkillOpt-Lite 和 GEPA 那样看 2 次 Rollouts,准确率也只有 48.6%。同时,在被单次执行分数判定为“优于基线”而放行接受的候选中,高达 62.1% 实际上是比基线更差的负优化(False Acceptance)。这也解释了图 4b 的现象:哪怕让选择器看完全部 100 个候选,它挑出的产物质量也只相当于完美 Oracle 看不到 5 个候选时的水平。
- 引入 LLM-as-a-Judge 并没有恢复分辨率:很多研究者直觉上认为,终端 Pass/Fail 只有一个比特的信息,如果让大模型做裁判(Judge)去通读完整的交互轨迹(Trajectory),应该能看清候选 Skill 到底有没有帮上忙。然而,无论是单点打分、双向成对比较,还是套用 ACE 的反思模板,LLM 裁判的成对准确率都在 45.4%~49.0% 之间。
为什么读了完整轨迹反而没用?从方差分解的角度看其实很容易理解:轨迹本身已经包含了环境执行的采样噪声 \(\epsilon_{\text{env}}\),而裁判模型在阅读长篇复杂日志时,不仅自身能力有限,还额外引入了一层与之独立的“阅读评判噪声” \(\epsilon_{\text{judge}}\)。两层独立噪声叠加而非抵消(\(\sigma^2_{\text{total}} = \sigma^2_{\text{env}} + \sigma^2_{\text{judge}}\)),反而让选择器变得更“瞎”了。
多轮误差累积与可能的出路
当单步选择退化为抛硬币时,把它放进多轮进化循环里反复迭代,就会产生我们在第一篇里提到过的两个累积效应(验证推论 P3):
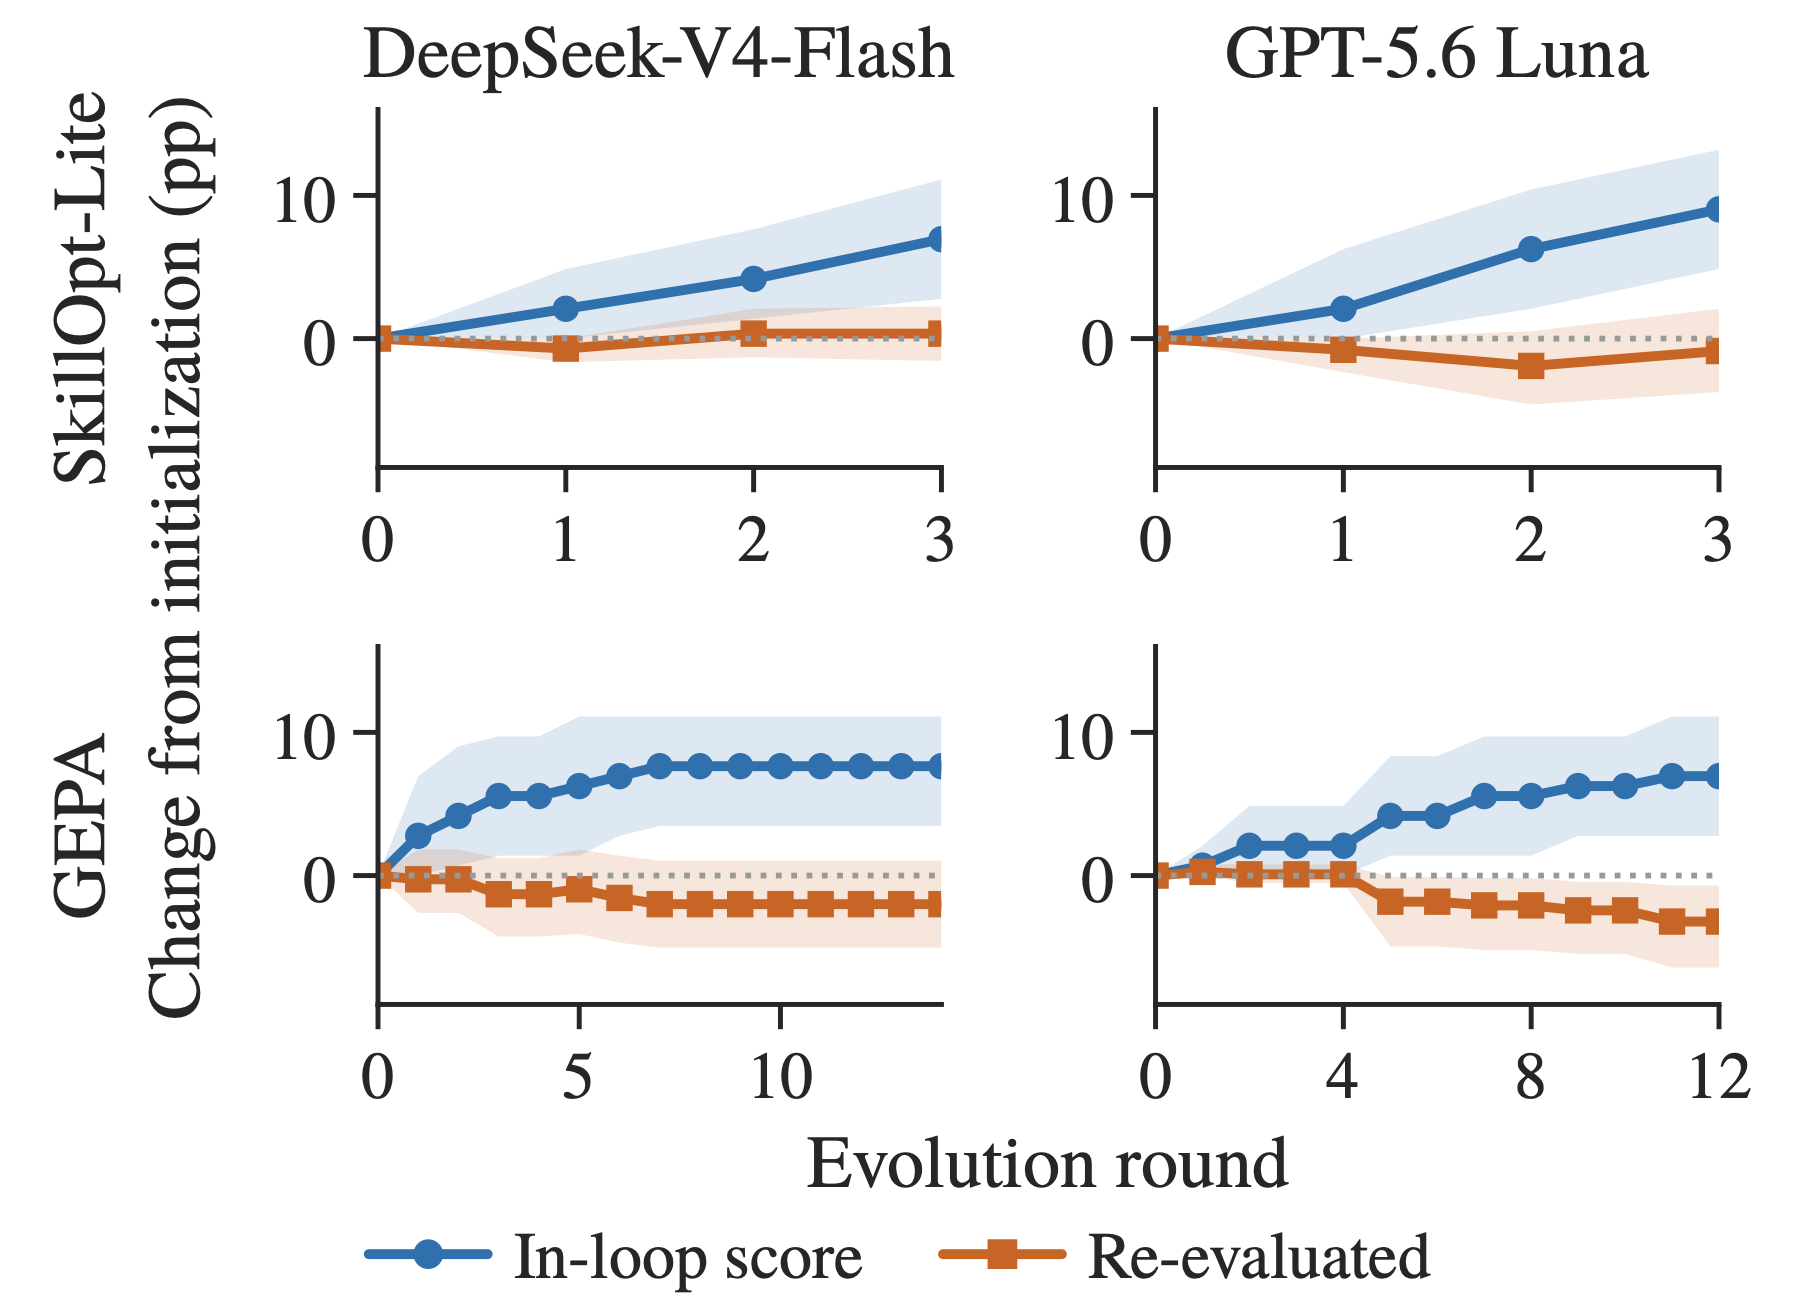
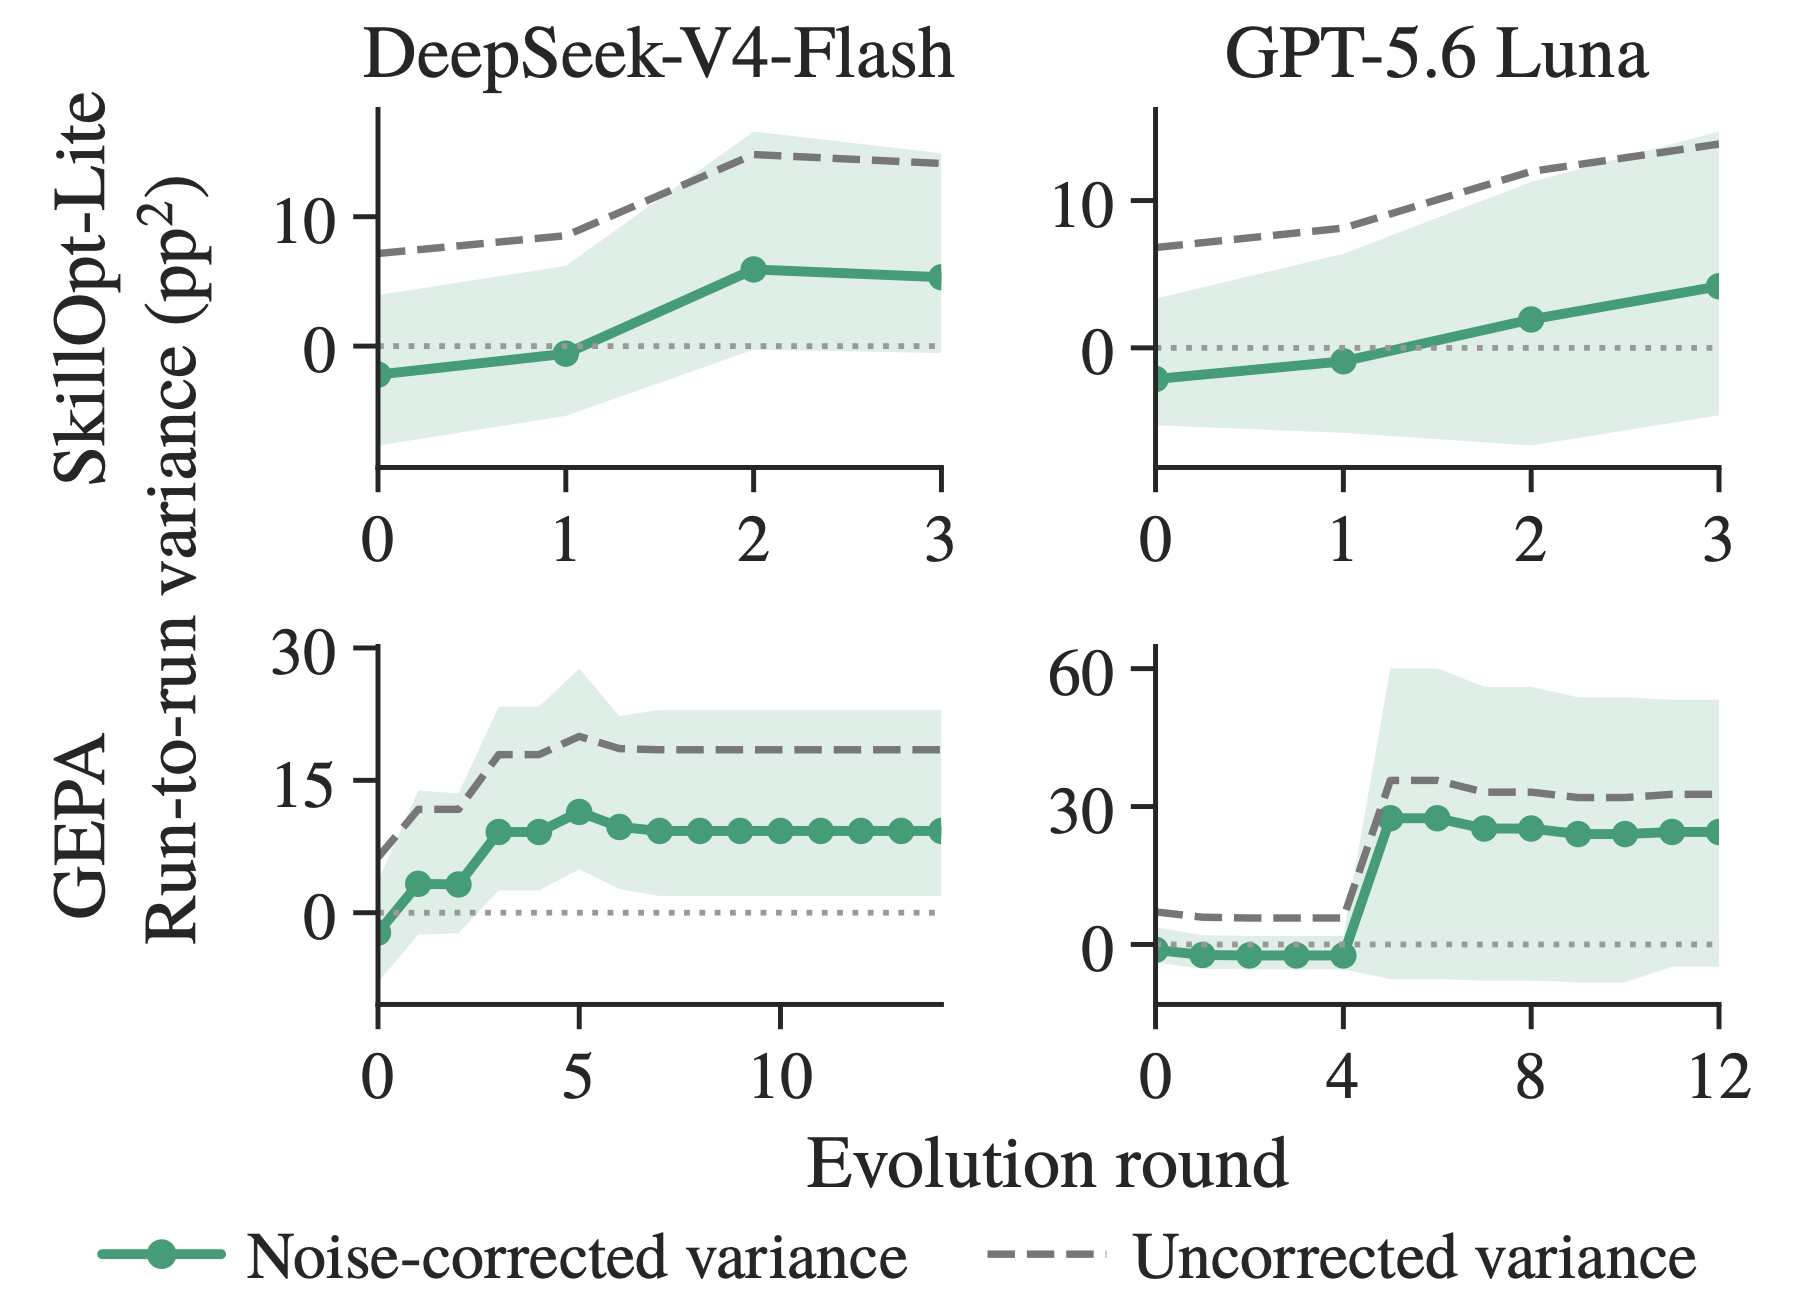
(上图展示循环内验证分虚高与重评估持平;下图展示运行间方差随轮次膨胀)
一是循环内的噪声套利(Noise Exploitation):由于接受准则总是用候选的带噪高分去替换当前产物,相当于每一轮都在采集噪声分布右尾的幸运极值(\(\max_{t} \epsilon_t\))。这导致图 5 中算法自己记录的验证集分数(蓝线)一路上涨了 \(+6.9\sim 9.0\text{ pp}\),而独立 8 倍重测的真实能力(橙线)却停留在 \(+0.35\sim -3.21\text{ pp}\) 纹丝不动。
二是跨运行的随机游走(Random Walk):图 6 中,所有运行从同一个初始产物出发(\(\tau_0^2 = 0\)),但每一轮近乎随机的抛硬币选择把不同运行推向了产物空间的不同角落,导致消噪后的运行间方差 \(\hat{\tau}_t^2\) 随轮次单调膨胀至 \(4.2\sim 24.5\text{ pp}^2\)——这正是第一篇中导致方法级排名剧烈动荡的元凶。
聊到这里,我们在研究过程中曾做过一个非常直接的尝试(记录在论文附录 F.3):既然一切的病根在于选择器看 1 次 Rollout 噪声太大,那如果我们不改算法,单纯在进化循环内部把每次验证评估强行加码到 16 次独立 Rollouts 取平均(把 \(\sigma\) 压低到原来的 \(1/4\)),进化能不能活过来?
因为每轮测 16 遍在 Terminal-Bench 上极其昂贵,我们只用 SkillOpt-Lite 跑了一个包含 16 次独立运行的小规模先导实验(最多 8 轮)。结果非常有趣:
- 好消息是,高分辨率验证确实把进化救活了:在 32 次独立测试集采样下,进化出的最优产物得分从常规验证的 64.8% 大幅跃升至 72.7%(跨运行均值也从 61.4% 升至 64.4%)。回看日志我们发现,常规单次验证往往在前 4 轮内就会因为某次偶然测出 80% 的幸运高分而把门槛“焊死”,后续真正优秀的候选再也跨不过去;而 16 倍采样消除了这种幸运极值锁死。
- 但我们也发现了高分辨率带来的一个新问题——过度保守(Conservatism):当评估方差被压得很低后,只要当前产物已经达到了一个还算不错的水平,任何带有探索性质的修改一旦不能立刻在均值上带来净提升,就会被选择器稳稳拒之门外,这导致算法变得不愿替换当前产物,反而在一定程度上限制了多步探索。
我们接下来该往哪里走?
显然,在日常研发中靠 16 倍采样去硬堆分辨率是不现实的。那么,有没有不靠暴力堆算力就能提升分辨率的出路?
其实相邻方向似乎已经做 work 了——确定性程序进化(Program Evolution),比如用大模型进化 GPU CUDA Kernel(KernelAgent)、搜索 ARC-AGI-2 的解题代码或 Atari 策略。为什么那个方向的进化能持续累积出惊人的突破,而通用 Agent 的 Prompt/Skill 进化却频频卡壳?
在我们的方差框架下,答案似乎很清晰:因为确定性代码的重评估极其廉价,且编译器报错、硬件耗时剖析(Profiling)给出的反馈噪声 \(\sigma^2 \approx 0\),分辨率天然处于理想状态。
受此启发,我们认为未来的 Agent 自进化研究,应当从“一味设计更花哨的 Proposer”,转向以下两个“分辨率感知(Resolution-Aware)”的方向:
1. 候选级:用低方差的“过程行为指标”充当高分辨率听诊器
终端的 Pass/Fail 奖励把几十步的交互压缩成了 0 或 1,信噪比极低。但如果我们用确定性脚本去测量智能体在轨迹中的中间过程行为(Process Metrics)——例如统计“智能体在修改代码文件后,紧接着运行测试命令进行验证且未掩盖错误诊断输出的比例”——它的方差会有多大?
我们在 DeepSeek-V4-Flash 的轨迹上实测发现:在全部 7 种进化方法与基线上,这一过程指标的评估噪声方差 \(\sigma^2_{\text{behavior}}\) 比终端奖励方差 \(\sigma^2_{\text{reward}}\) 小了整整 13~57 倍!
借由这几十倍的分辨率提升,过程指标清晰地照出了终端通过率完全看不见的行为偏移(例如 Trace2Skill 让编辑后验证率显著提升了 \(+8.73\text{ pp}\),\(z=2.17\);而 AHE 反而让该良性行为率下降了 \(17.98\text{ pp}\),\(z=-4.19\))。
当然,过程指标本身是“诊断听诊器”而非终极目标——多跑测试不代表一定能修好 Bug,如果直接拿它当唯一的选择目标,又会面临新的捷径问题。但如何利用这类低方差的过程信号做预过滤门控(Pre-commit Gating),或者将其与终端奖励结合构建多保真度(Multi-fidelity)选择器,是一个非常值得深挖的课题。
2. 方法级:用“组件级解耦评估”替代端到端黑盒拼运气
在评估新提出的进化算法时,与其在低于单次分辨率极限的端到端测试集分数上争论谁比谁高了 \(2\text{ pp}\),我们更建议将评估拆成两个高于分辨率的独立诊断实验:
- 测提议器(Proposer):在基准任务上画出后验
Quality@K曲线,直接检验你的反思机制能否比随机基线产出上限更高的候选池; - 测选择器(Selector):在同一个已知真实后验质量的静态候选池(如我们将开源的 100-Skill 基准池)上画出“质量恢复曲线”。这不仅彻底消除了运行间方差 \(\tau^2\),而且完全不需要重跑昂贵的容器环境交互,几分钟就能验出选择器的真实分辨率。
结语
回顾这 1,030 次进化运行与 210 万条轨迹,我们的结论其实非常朴素:自进化智能体能达到的上限由提议器(Proposer)决定,但它实际上能留存并累积多少改进,则完全受制于评估系统的分辨率(Resolution)。
当分辨率不足时,真正的细微进步在噪声中得而复失,唯有钻评测漏洞的捷径能大行其道。先把评估的“显微镜”擦亮——无论是报告多次运行的方差(\(\tau\) 与 \(\sigma\))、引入低方差的过程诊断指标,还是解耦评估提议与选择组件——或许才是让 Agent 自进化走出“玄学调优”、迈向真正持续累积的第一步。
- 论文全文(arXiv):https://arxiv.org/abs/2611.23068
- 项目主页、交互式数据浏览器与 30 秒互动小游戏:/resolution-hypothesis/
- 作者幕后手记:我们本来想做一个 Agent 进化算法,最后却给这个领域做了一次全面体检
Enjoy Reading This Article?
Here are some more articles you might like to read next: